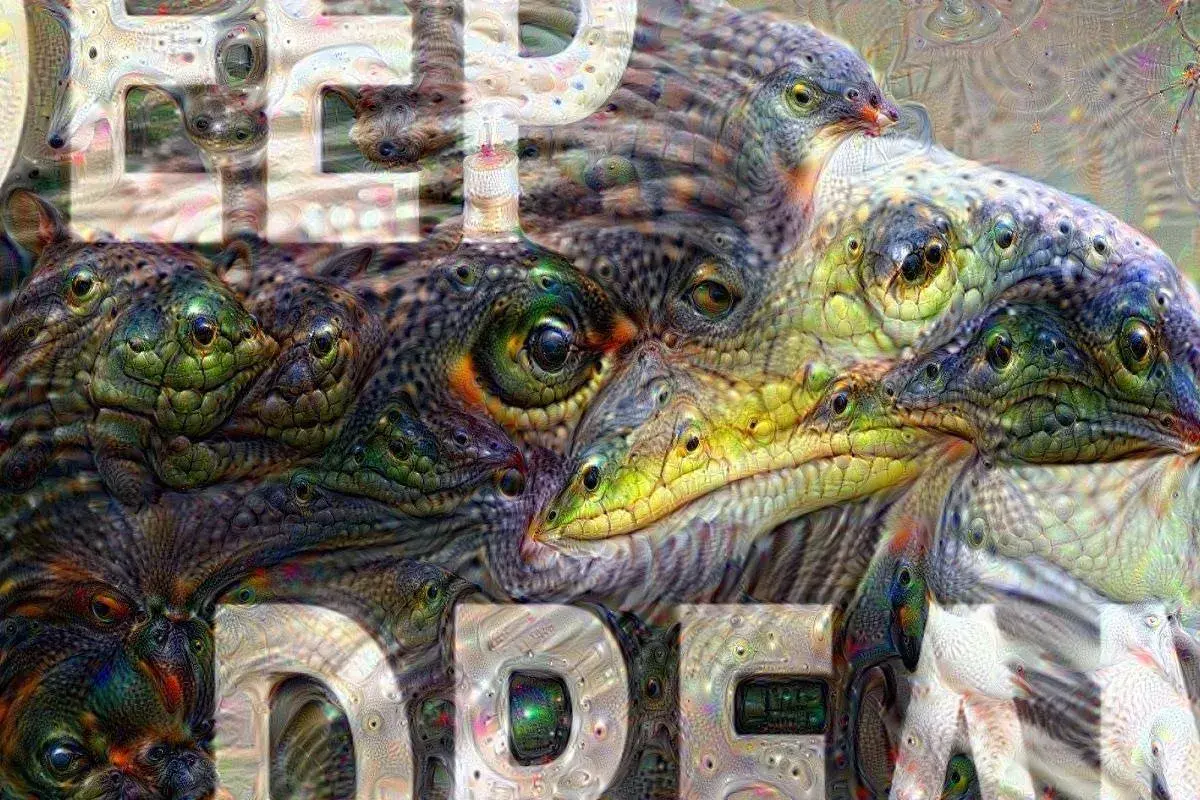
Une photo banale peut soudain faire surgir des yeux, des museaux ou des formes presque hallucinatoires. Le deep dream est une technique de vision par ordinateur qui amplifie les motifs reconnus par un réseau neuronal pour créer des images oniriques, parfois fascinantes, parfois franchement dérangeantes. Je vous explique son fonctionnement, la manière de l’utiliser en création visuelle et les limites à connaître avant de lui confier vos images.
Une méthode qui transforme les erreurs d’un réseau neuronal en langage visuel
- Principe : l’algorithme amplifie les motifs déjà détectés dans une image.
- Résultat : des formes répétées, des animaux, des yeux et des textures apparaissent de façon imprévisible.
- Réglages : les couches du réseau, le nombre d’itérations et les échelles modifient fortement le rendu.
- Meilleure base : les images riches en textures et en détails donnent souvent les résultats les plus intéressants.
- Limite : il ne s’agit pas d’un générateur texte-image, mais d’une transformation guidée par une image existante.
Pourquoi ces images semblent-elles rêver à notre place
Le procédé a été popularisé par les ingénieurs de Google au milieu des années 2010. Il repose sur un réseau neuronal convolutif, c’est-à-dire un modèle capable d’analyser progressivement les contours, les textures puis les objets présents dans une image.
Le réseau ne « voit » pas comme nous. Il calcule des probabilités à partir de motifs appris pendant son entraînement. Lorsqu’il reconnaît vaguement une forme animale dans un nuage ou une architecture, l’algorithme peut renforcer cette interprétation jusqu’à faire apparaître un œil, une patte ou un museau qui n’existait pas dans la photo originale.
J’aime cette technique pour une raison simple. Elle ne cherche pas à produire une image parfaitement réaliste. Elle révèle plutôt les associations étranges d’un modèle informatique, avec ses obsessions et ses erreurs. Les fameux chiens qui se répètent partout ne sont donc pas un hasard, mais la conséquence d’une forte activation de certains neurones spécialisés dans la reconnaissance de formes.
Le résultat est souvent qualifié de surréaliste, mais le terme est un peu réducteur. Il s’agit surtout d’une visualisation des représentations internes d’un réseau neuronal. L’image montre moins ce que l’ordinateur comprend vraiment que ce qu’il essaie de faire correspondre à ce qu’il connaît déjà.
Comment l’algorithme transforme une photo
Le fonctionnement peut sembler mystérieux, alors qu’il suit une logique assez précise. On fournit une image à un modèle de vision, souvent basé sur une architecture de type Inception. Le modèle analyse ensuite cette image à travers plusieurs couches, chacune étant sensible à un niveau de détail différent.
Les premières couches travaillent la texture
Les couches situées au début du réseau repèrent principalement les lignes, les contrastes et les motifs simples. En les amplifiant, on obtient des effets proches d’une peinture abstraite ou d’une texture organique. C’est une bonne option pour les fonds, les paysages et les images destinées à devenir des matières graphiques.
Les couches profondes recherchent des objets
Plus on avance dans le réseau, plus les motifs deviennent complexes. Certaines activations correspondent à des formes qui ressemblent à des animaux, des visages, des bâtiments ou des objets. L’algorithme modifie alors légèrement les pixels afin d’augmenter l’activation de ces formes. Cette opération s’appelle la descente de gradient inversée, ou montée de gradient lorsqu’on cherche à maximiser le signal.
En pratique, le modèle effectue une boucle. Il analyse l’image, calcule les gradients, modifie les pixels, puis recommence. Après quelques dizaines d’itérations, des détails commencent à se dessiner. Avec 50 à 100 étapes, on obtient déjà un effet visible, tandis qu’un traitement plus long produit des motifs beaucoup plus envahissants.
Les octaves ajoutent des détails à plusieurs échelles
Une seule échelle donne souvent une image bruyante, où tous les détails ont la même taille. La méthode des octaves consiste à appliquer le traitement à plusieurs résolutions successives. Les petites formes apparaissent d’abord, puis l’image est agrandie afin que le réseau ajoute des détails plus fins.
Avec trois à cinq échelles, le rendu devient généralement plus riche. Il faut toutefois surveiller la montée en puissance de l’effet. Une image trop travaillée perd rapidement son sujet initial et devient une accumulation de motifs sans hiérarchie.
Créer une image réussie sans perdre son intention
Le résultat dépend beaucoup plus de l’image de départ qu’on ne l’imagine. Une photo uniforme, sombre ou très floue laisse peu de prises au réseau. À l’inverse, une image présentant des textures, des silhouettes et des contrastes nets offre davantage de matière à amplifier.
Choisir une bonne image de départ
- Un paysage nuageux favorise les textures et les formes animales.
- Une forêt dense produit des répétitions organiques, souvent très spectaculaires.
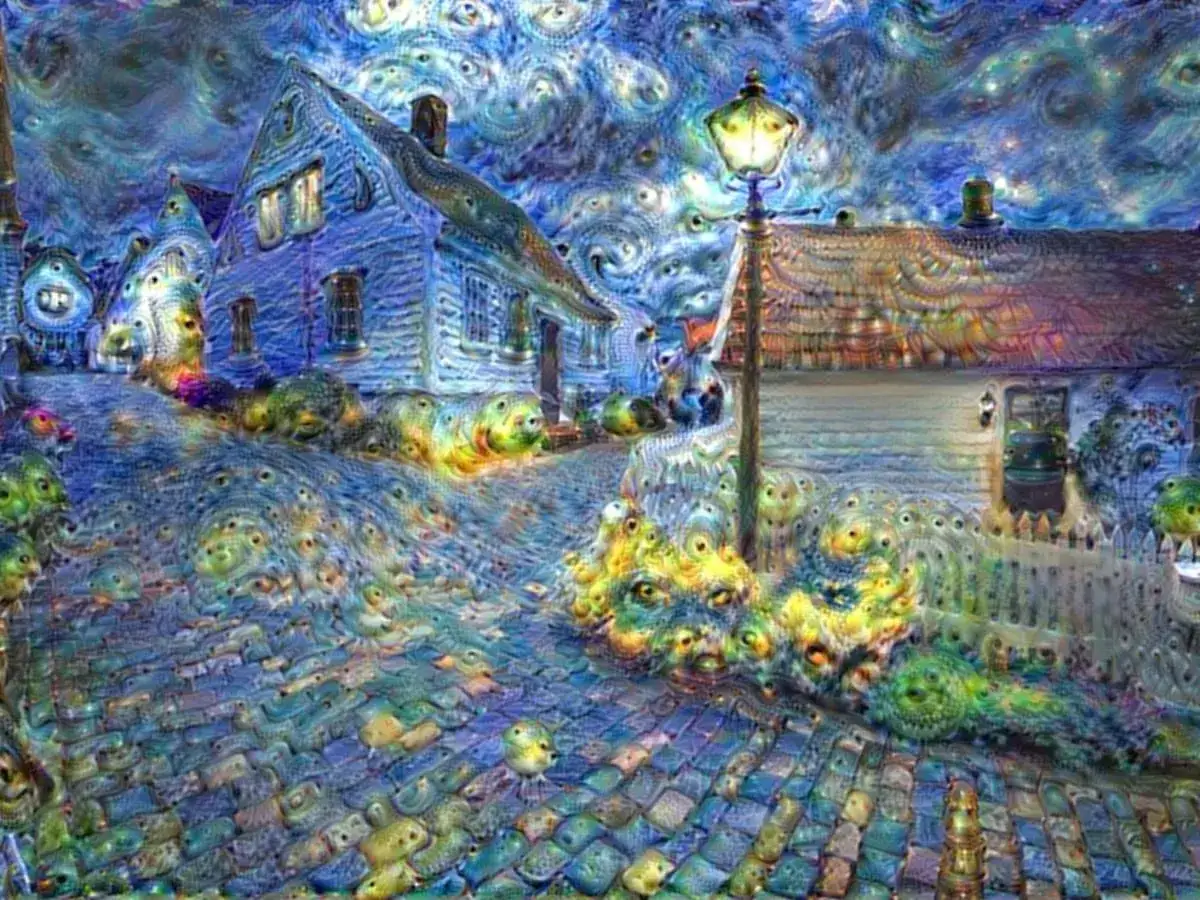
- Une façade ou une rue font ressortir les lignes, les fenêtres et les structures géométriques.
- Un portrait peut devenir intéressant, mais les visages se déforment vite et l’effet devient parfois artificiel.
- Une photo très minimaliste convient mieux aux premières couches qu’aux couches profondes.
Je conseille de commencer avec une image dont le sujet reste identifiable. Le contraste entre une base reconnaissable et les hallucinations produites par le réseau crée une vraie tension visuelle. Si tout est déjà confus au départ, le traitement ne fera souvent qu’ajouter du désordre.
Régler l’intensité progressivement
Il vaut mieux produire plusieurs versions légères qu’une seule transformation extrême. Je commence généralement avec un pas de modification faible, puis j’augmente progressivement l’intensité. Une valeur trop forte crée des contours cassés et des couleurs sales avant même que les formes intéressantes aient le temps d’apparaître.
La taille de l’image compte aussi. Pour un premier essai, une image de quelques centaines de pixels de côté suffit. Une résolution plus élevée demande davantage de mémoire et de temps de calcul, sans garantir un meilleur résultat. Je préfère obtenir une composition forte en basse résolution, puis l’agrandir et la retoucher ensuite.
Lire aussi : Reflets crédibles - Photo & 3D - Le secret de la crédibilité
Garder plusieurs étapes du traitement
La première version n’est pas toujours la meilleure. Un rendu intermédiaire peut conserver la profondeur de la photo tandis que la version finale devient trop chargée. Enregistrez donc plusieurs étapes et comparez-les à taille réelle, pas seulement en zoomant sur les détails.
Pour une série photographique, cette méthode permet aussi de créer une cohérence. En utilisant les mêmes couches et des réglages proches sur plusieurs images, on obtient une famille visuelle reconnaissable, ce qui fonctionne bien pour une exposition, une couverture ou une identité éditoriale.
Quels usages pour la photographie et la création visuelle
Le traitement est particulièrement intéressant lorsque l’image doit suggérer une sensation plutôt que documenter un lieu. Il peut transformer une photographie de forêt en paysage mental, une architecture en organisme vivant ou un portrait en étude de perception.
| Usage | Approche recommandée | Effet recherché |
|---|---|---|
| Affiche artistique | Couches profondes et contraste marqué | Créer un impact immédiat |
| Couverture éditoriale | Traitement modéré et zone calme pour le texte | Conserver une lecture claire |
| Série photographique | Réglages identiques sur plusieurs images | Construire une unité visuelle |
| Texture ou arrière-plan | Couches intermédiaires et recadrage | Obtenir une matière exploitable |
Dans un projet commercial, je déconseille d’utiliser l’effet comme simple décoration. Il fonctionne mieux quand il sert une idée précise, par exemple la surcharge informationnelle, la mémoire, la perception ou la frontière entre nature et technologie. Une intention claire fait souvent davantage la différence que la puissance du réglage.
Cette technique peut aussi nourrir un travail de direction artistique. Une image produite par le réseau devient une base que l’on peut recadrer, coloriser, superposer à une photographie ou combiner avec du dessin. Le traitement informatique n’est alors qu’une étape dans une chaîne plus large de création.
Il faut toutefois la distinguer des outils génératifs modernes. Ici, l’algorithme part d’une image existante et amplifie les motifs d’un modèle. Il ne comprend pas une consigne en langage naturel et ne compose pas librement une scène à partir d’une description.
Ce que la méthode ne fait pas et les erreurs à éviter
Le résultat n’est pas une lecture objective de l’image. Si le réseau fait apparaître des animaux, cela ne signifie pas qu’ils étaient réellement cachés dans la photographie. Il s’agit d’une interprétation statistique, influencée par les données utilisées pour entraîner le modèle et par la couche sélectionnée.
La première erreur consiste à augmenter tous les réglages en même temps. Davantage d’itérations, un pas plus fort et plusieurs couches profondes peuvent rapidement produire une image saturée. Je préfère modifier un seul paramètre à la fois afin de comprendre ce qui change réellement.
La deuxième erreur est de croire qu’une image plus détaillée est forcément meilleure. Un excès de détails détruit la composition, attire le regard partout et rend le sujet illisible. Pour une utilisation éditoriale, il faut souvent laisser des zones de respiration, même si elles paraissent moins impressionnantes dans une galerie d’images.
Le calcul peut également devenir lourd. Le traitement à plusieurs échelles sollicite fortement le processeur ou la carte graphique, surtout avec de grandes images. Le code historique publié par Google est désormais archivé, tandis que des exemples plus récents existent dans l’écosystème TensorFlow. Pour expérimenter, un notebook prêt à l’emploi est généralement plus simple qu’une installation complète.
Enfin, vérifiez les droits liés à la photographie de départ et aux éléments reconnaissables qui y figurent. Le fait qu’une image soit transformée par un algorithme ne règle pas automatiquement les questions de droit à l’image, de licence ou d’utilisation commerciale.
Ce que je retiens pour une création qui a quelque chose à dire
Cette méthode reste intéressante parce qu’elle montre une autre manière de travailler avec une image. Elle ne remplace ni la photographie ni les générateurs d’images, mais elle révèle les associations particulières d’un réseau neuronal et les transforme en matière artistique.
Pour obtenir un résultat convaincant, je retiens trois règles simples. Choisir une base riche en formes, avancer par petites étapes et arrêter le traitement avant que les motifs ne prennent toute la place. Le plus beau résultat n’est pas forcément le plus spectaculaire, mais celui où la photographie d’origine et l’interprétation de la machine restent visibles ensemble.